
在地端 AI / RAG 系統裡,使用者丟進來的第一句話,往往決定了後面整條處理鏈要走哪條路。如果每一句話都直接丟給大型 LLM 去判斷意圖,準確度是有了,但代價是「慢」跟「貴」,尤其地端環境資源有限,或是流量一大,這種做法很快就撐不住。反過來,如果全部都用一個自己訓練的小模型去判斷,速度快、成本低,但遇到模糊、多義、或訓練資料沒覆蓋到的說法時,準確度就會掉下去。
這篇要介紹的架構,就是在這兩難之間找平衡:用小模型做第一線快篩,只有真的沒把握的案例,才交給 LLM 做第二線精篩。這是一種常見的 cascading(層級式)分類設計,概念上跟很多系統用快取 + 資料庫、或用規則引擎 + 模型做 fallback 是同一套思路。
其實就是一條「輸入 → 判斷 → 決策 → 交棒」的流水線,拆成六個環節: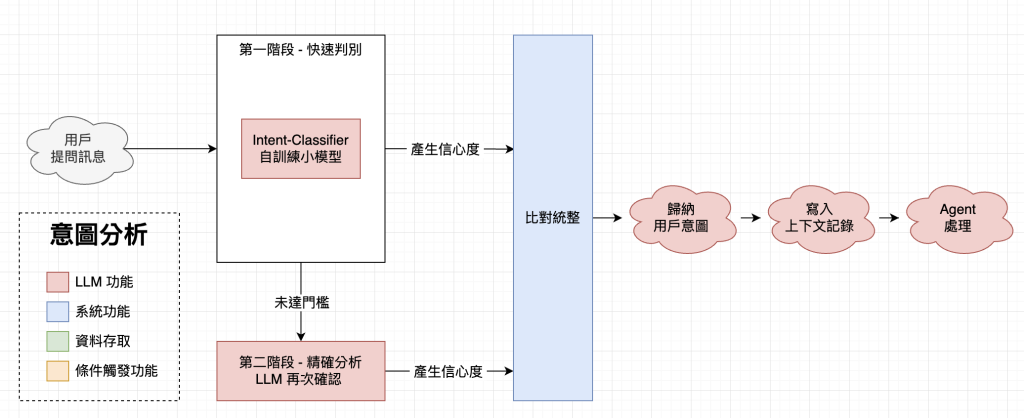
流程的起點,就是使用者輸入的原始文字。這一步不做任何處理,純粹是資料入口,但實作時建議在這裡先做基本的前處理(去除多餘空白、統一編碼、必要時做簡單的敏感詞過濾),讓後面的分類器拿到的是乾淨的輸入。
這是整個架構的「守門員」,重點是快跟便宜。實作上常見的選擇:
傳統機器學習:TF-IDF + SVM / Logistic Regression,訓練快、部署輕,適合意圖類別少、語料明確的場景。
輕量神經網路:fine-tuned 的小型 Transformer(例如 DistilBERT、MiniLM 這類),準確度比傳統 ML 好,但仍遠比呼叫大型 LLM 便宜。
這個模型的輸出不只是「意圖類別」,還要輸出一個信心度分數(confidence score),這個分數是接下來能不能「一次判斷完」的關鍵依據。
實作重點提醒:這一階段的模型需要「自己的訓練資料」,也就是你要準備一批標註過意圖類別的問句語料。資料量不用到大型 LLM 那種規模,但類別的涵蓋度跟每類的樣本數要足夠,不然信心度分數容易失準。
這是整個設計的靈魂所在:用一個門檻值,決定要不要升級處理。
信心度 ≥ 門檻:代表小模型判斷得很有把握,直接把結果送去「比對統整」。
信心度 < 門檻(未達門檻):代表小模型自己也不確定,此時不要硬判,而是把這句話轉交給第二階段的 LLM 重新分析。
實作上,這個門檻值不是拍腦袋定的,通常會透過驗證集(validation set)觀察不同門檻下的準確率/召回率曲線,抓一個能兼顧「大部分交給小模型處理」跟「保留品質」的平衡點。門檻設太低,模糊案例會被小模型誤判;設太高,等於大部分請求都要繞去 LLM,失去了兩階段設計省成本的意義。
只有「未達門檻」的少數案例才會走到這裡,所以就算 LLM 呼叫成本較高、延遲較長,整體系統負擔也還在可控範圍。
這一階段的 LLM 通常會拿到:
同樣地,這一步也要輸出信心度,讓後面的「比對統整」有依據可以判斷。
這一塊是純系統邏輯,它做的事情很單純:把送進來的信心度(可能只有第一階段的,也可能兩階段都有)拿來做規則判斷,決定最終要採用哪一個結果。常見規則像是:
只有第一階段結果 → 直接採用。
兩階段都有結果 → 通常以第二階段(LLM)的判斷為準,但也可以設計成「兩者一致才採信,不一致則標記為低信心,交由 Agent 端再做確認」。
這一步的價值在於把「模型判斷」跟「系統決策」分開,方便你之後獨立調整規則,而不用重新訓練模型。
比對統整後,系統會把最終確認的意圖歸納成結構化格式(例如意圖標籤、相關參數),接著寫入上下文記錄 — 這一步很關鍵,因為它讓後續對話有「記憶」,Agent 才能根據多輪對話的脈絡做出連貫的回應,而不是每次都從零判斷。最後才真正交給 Agent 去執行對應的動作或回答邏輯。
小模型的類別設計:意圖類別不要一開始就切太細,先抓大方向(例如:查詢資料 / 執行操作 / 閒聊 / 需要澄清),太細的分類會讓小模型訓練資料需求暴增,也更容易誤判。
信心度門檻要能動態調整:建議把門檻值做成可設定的參數(甚至是可以依意圖類別分別設定),而不是寫死在程式碼裡,方便日後根據線上表現微調。
記錄每次的判斷路徑:建議把「走第一階段就結束」還是「有升級到第二階段」都記錄下來,這份資料之後可以拿來重新訓練、優化小模型,讓小模型隨時間越來越準,減少對 LLM 的依賴。
比對統整的規則要版本化:這塊雖然是系統邏輯而非模型,但規則變動也會直接影響最終結果,建議跟模型一樣做版本控管與測試。
這篇的核心概念,用一句話講完就是:先讓便宜的模型處理大多數簡單案例,把珍貴的 LLM 資源留給真正模糊的問題。這種分層設計不只省成本,也讓系統有清楚的「可觀測性」— 你可以清楚知道每一句話是被誰判斷的、信心度多少、有沒有升級,這對後續除錯跟優化非常重要。


 iThome鐵人賽
 看影片追技術